Auto-Increment, UUIDv4 và UUIDv7: Chọn Primary Key Sao Cho Database Không Khóc?
Khi tạo một table mới, câu hỏi tưởng nhỏ nhưng ảnh hưởng rất lâu dài là:
Dùng gì làm primary key?
Trong nhiều năm, câu trả lời mặc định là AUTO_INCREMENT, SERIAL, BIGSERIAL, hoặc IDENTITY: cứ tăng dần 1, 2, 3, 4... là xong.
Sau đó hệ thống lớn dần, bắt đầu có API public, microservices, multi-region, event-driven architecture… và ta nghe lời khuyên quen thuộc:
“Đừng dùng integer nữa, dùng UUID đi.”
Nhưng đổi từ integer sang UUID không chỉ là đổi format ID. Nó thay đổi cách database lưu, sắp xếp, đánh index và đọc dữ liệu ở tầng rất thấp.
Bài này phân tích dựa trên video Auto-Increment vs UUID Explained in 5 Minutes, nhưng mình sẽ đi sâu hơn một chút dưới góc nhìn backend/database.
TL;DR
| Loại ID | Điểm mạnh | Điểm yếu | Nên dùng khi |
|---|---|---|---|
| Auto-increment integer | Nhanh, nhỏ, index gọn, insert thân thiện với B-tree | Dễ đoán, lộ volume, khó sinh ID phi tập trung | App đơn node, ID nội bộ, workload đơn giản |
| UUIDv4 | Sinh ID ở bất kỳ đâu, gần như không trùng, khó đoán | Random insert làm B-tree page split/fragmentation, tốn dung lượng | Distributed system cần ID độc lập, nhưng write volume không quá nhạy hoặc dùng cho external ID |
| UUIDv7 | Có thứ tự theo thời gian, sinh phân tán, khó đoán hơn integer, index-friendly hơn UUIDv4 | Vẫn 16 bytes, có thể lộ timestamp tương đối, cần support/library đúng | API public, distributed systems, event-driven, muốn cân bằng performance và uniqueness |
Kết luận ngắn:
- Nếu ID chỉ dùng nội bộ, hệ thống đơn giản: auto-increment vẫn rất ổn.
- Nếu cần ID sinh độc lập ở nhiều node: đừng mặc định chọn UUIDv4 nếu write/index performance quan trọng.
- Nếu muốn vừa phân tán vừa thân thiện với index: UUIDv7 là lựa chọn rất đáng cân nhắc.
1. Auto-increment integer: nhanh vì database thích sự tuần tự
Ví dụ:
1, 2, 3, 4, 5, 6...
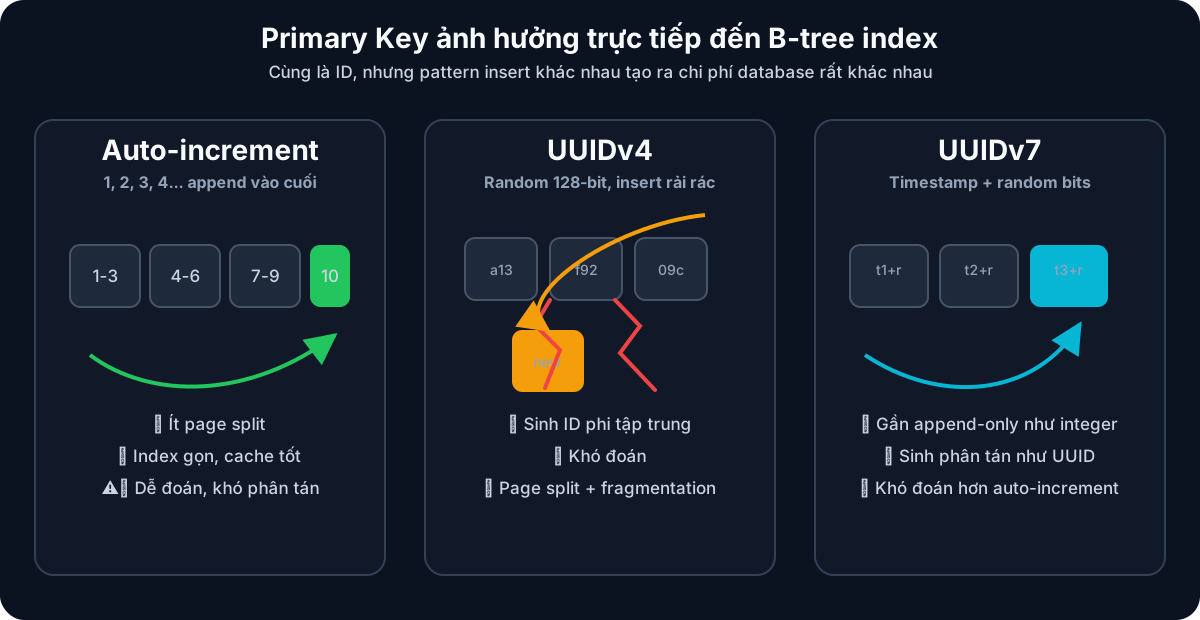
Trong PostgreSQL, MySQL, SQL Server…, primary key thường được đánh index bằng B-tree hoặc cấu trúc tương tự B-tree.
B-tree lưu key theo thứ tự. Khi ID tăng dần, record mới luôn có key lớn hơn record cũ. Database gần như chỉ cần append record mới vào right-most page của index.
Hình dung đơn giản:
[1,2,3] [4,5,6] [7,8,9] -> insert 10 vào cuối
Không cần chen vào giữa. Không cần tìm một page ngẫu nhiên. Không cần di chuyển nhiều dữ liệu.
Ưu điểm của auto-increment
1.1. Nhỏ gọn
Kích thước thường gặp:
| Kiểu | Kích thước |
|---|---|
INT | 4 bytes |
BIGINT | 8 bytes |
UUID | 16 bytes |
Primary key nhỏ giúp:
- Primary index nhỏ hơn.
- Secondary index nhỏ hơn.
- RAM/cache chứa được nhiều key hơn.
- Join/sort/lookup thường rẻ hơn.
1.2. Insert nhanh, ít fragmentation
Vì ID tăng dần nên insert chủ yếu rơi vào cuối B-tree.
Kết quả:
- Ít page split.
- Ít random I/O.
- Ít write amplification.
- Cache locality tốt.
- Dễ đạt throughput cao.
1.3. Dễ debug
Nhìn order_id = 120391 dễ hơn nhìn 018fd6a8-8b2c-7c41-b9e9-1b2c9a6e88f1.
Log, ticket support, dữ liệu test, migration script… đều dễ đọc hơn.
Nhược điểm của auto-increment
1.4. Dễ đoán, dễ enumeration
Nếu API có dạng:
GET /users/42
GET /users/43
GET /users/44
attacker có thể thử tăng/giảm ID để dò dữ liệu.
Đây là bối cảnh rất hay dẫn tới IDOR — Insecure Direct Object Reference.
Nhưng cần nói rõ: auto-increment không tự tạo ra IDOR. IDOR xảy ra khi hệ thống thiếu authorization check. ID tuần tự chỉ làm attacker dễ đoán object hơn.
Ví dụ sai:
User A gọi /invoices/1002
Server thấy invoice 1002 tồn tại
Server trả dữ liệu mà không kiểm tra invoice đó có thuộc User A không
Dù dùng UUID, authorization vẫn phải đúng. UUID không thay thế quyền truy cập.
1.5. Lộ thông tin business
ID tăng dần có thể tiết lộ:
- Số lượng user/order.
- Tốc độ tăng trưởng.
- Sản lượng giao dịch.
- Thứ tự tạo dữ liệu.
Ví dụ hôm nay order ID là 100000, tuần sau là 130000, người ngoài có thể suy đoán volume tương đối.
1.6. Khó sinh ID phi tập trung
Trong hệ thống nhiều node cùng ghi, câu hỏi là:
Ai cấp ID tiếp theo?
Nếu Server A và Server B cùng insert, cả hai không thể tự đoán “ID kế tiếp” nếu không có cơ chế điều phối.
Một số cách xử lý:
- Central sequence/database sequence.
- Lock hoặc transaction ở một nơi trung tâm.
- Cấp range ID theo node.
- Sharding theo offset.
- Dùng Snowflake-like generator.
Các cách này đều làm kiến trúc phức tạp hơn hoặc tạo bottleneck nếu thiết kế không cẩn thận.
2. UUIDv4: sinh ở đâu cũng được, nhưng database phải trả giá
UUIDv4 là giá trị 128-bit sinh gần như hoàn toàn từ random.
Ví dụ:
9f2c1a4e-3b0f-4f7e-8f41-cc8a6b7a2e11
Ưu điểm của UUIDv4
2.1. Gần như không trùng
Không gian 128-bit cực lớn. Nếu random generator tốt, xác suất collision trong thực tế gần như bằng 0 với phần lớn hệ thống.
2.2. Sinh ID độc lập ở bất cứ đâu
App server, worker, client, edge service, mobile app offline… đều có thể tự sinh ID mà không cần hỏi database.
Điều này rất hữu ích cho:
- Microservices.
- Event-driven architecture.
- Offline-first app.
- Multi-region writes.
- Queue/job systems.
- Tạo ID trước khi insert database.
2.3. Khó đoán hơn integer
URL kiểu này khó enumeration hơn nhiều:
/users/9f2c1a4e-3b0f-4f7e-8f41-cc8a6b7a2e11
Nhưng nhắc lại: khó đoán không có nghĩa là an toàn tuyệt đối. API vẫn phải check authorization.
Nhược điểm của UUIDv4
2.4. Random insert làm B-tree mệt
Vì UUIDv4 random, record mới không nằm ở cuối index. Nó có thể rơi vào bất kỳ vị trí nào trong B-tree.
Thay vì:
1, 2, 3, 4, 5, 6 -> append 7
nó giống như:
a13..., f92..., 09c..., b71... -> insert vào vị trí ngẫu nhiên
Database phải:
- Tìm đúng page chứa khoảng key đó.
- Insert vào giữa page.
- Nếu page đầy, thực hiện page split.
- Cập nhật parent nodes.
- Có thể ghi thêm nhiều page xuống disk/WAL/redo log.
2.5. Page split là gì?
Một index page có dung lượng giới hạn. Khi cần insert vào một page đã đầy, database phải tách page đó ra làm hai.
Ví dụ đơn giản:
Trước:
[ A, B, D, E ]  // page đầy

Insert C:
[ A, B, C, D, E ] // không còn chỗ

Page split:
[ A, B ] [ C, D, E ]
Page split gây tốn:
- CPU.
- I/O.
- WAL/redo log.
- Latch/lock contention.
- Cache churn.
Với write workload lớn, đây không còn là chi phí nhỏ.
2.6. Index fragmentation
Khi insert rải rác, các page logic gần nhau có thể không nằm gần nhau trên storage/cache. Index bị phân mảnh.
Hậu quả:
- Range scan đọc nhiều block hơn.
- Cache hit kém hơn.
- Index lớn hơn cần nhiều RAM hơn.
- Vacuum/reindex/maintenance tốn hơn.
2.7. Secondary index bloat
Đây là điểm rất nhiều dev bỏ sót.
Primary key không chỉ nằm trong primary index. Nó thường còn xuất hiện trong secondary index để trỏ về row gốc.
Với MySQL InnoDB, secondary index leaf record chứa primary key của row. Nếu primary key là UUID 16 bytes thay vì BIGINT 8 bytes, mọi secondary index đều phình theo.
Ví dụ table có 5 secondary indexes:
PK lớn hơn 8 bytes
x hàng triệu/billions rows
x 5 secondary indexes
= storage + memory overhead tăng rất rõ
PostgreSQL có cơ chế heap TID khác InnoDB, nên câu chuyện không giống 100%, nhưng UUID vẫn làm index key lớn hơn, ít key fit trong một page hơn, cache locality kém hơn.
2.8. Lưu UUID dạng string còn tệ hơn
Nếu lưu UUID bằng CHAR(36):
9f2c1a4e-3b0f-4f7e-8f41-cc8a6b7a2e11
thì tốn khoảng 36 bytes, chưa kể collation/encoding overhead tuỳ database.
Tốt hơn:
- PostgreSQL: dùng kiểu
uuid. - MySQL: dùng
BINARY(16)nếu tự quản lý binary UUID.
3. UUIDv7: timestamp ở đầu, randomness ở sau
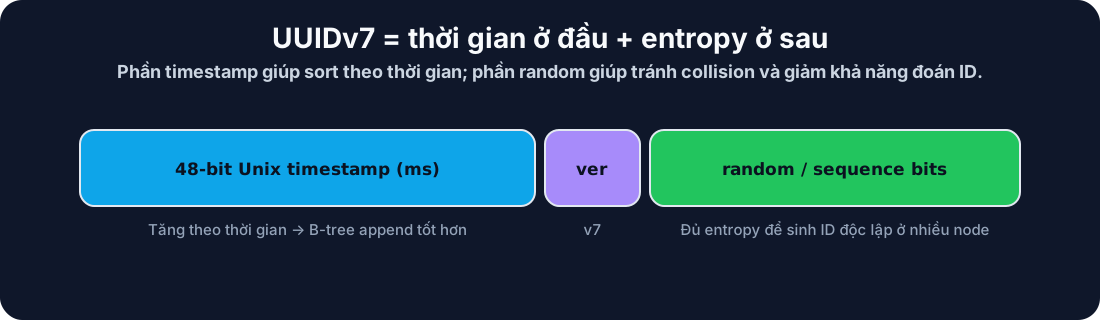
UUIDv7 là UUID thế hệ mới đã được chuẩn hoá trong RFC 9562. Ý tưởng cốt lõi:
Đưa timestamp vào phần đầu của UUID, sau đó thêm random bits để giữ uniqueness.
Cấu trúc đơn giản hoá:
[timestamp theo millisecond][version/variant][random bits]
Vì timestamp nằm ở phần đầu, UUIDv7 có xu hướng sort theo thời gian tạo.
Ví dụ minh hoạ:
018fd6a8-8b2c-7c41-b9e9-1b2c9a6e88f1
018fd6a8-8b2d-7a12-91cc-0a83f6d3c5aa
018fd6a8-8b2e-78f0-8f2d-834c0d60bb14
Các ID sinh sau thường lớn hơn ID sinh trước. Từ góc nhìn B-tree, nó gần giống pattern append của auto-increment hơn nhiều so với UUIDv4.
UUIDv7 giải quyết gì từ auto-increment?
3.1. Giảm phụ thuộc vào central ID generator
Auto-increment cần một nguồn cấp ID trung tâm hoặc một cơ chế phân phối ID.
UUIDv7 có thể được sinh ở nhiều app server/worker khác nhau mà không cần hỏi database trước.
Điều này giúp:
- Scale write tốt hơn.
- Hợp với microservices.
- Hợp với event sourcing/event logs.
- Hợp với multi-node systems.
- Có thể tạo ID trước khi persist.
3.2. Khó đoán hơn ID tuần tự
Auto-increment:
/users/42 -> /users/43
UUIDv7:
/users/018fd6a8-8b2c-7c41-b9e9-1b2c9a6e88f1
Attacker không thể đơn giản cộng thêm 1 để đoán object kế tiếp.
Tuy vậy UUIDv7 có timestamp ở đầu, nên nó có thể lộ thời điểm tạo tương đối. Nếu cần che giấu tuyệt đối metadata thời gian, phải cân nhắc thêm.
3.3. Ít lộ số lượng record hơn
ID tuần tự làm lộ volume khá trực tiếp. UUIDv7 không lộ số thứ tự tăng dần theo kiểu 10001, 10002, 10003.
Nó vẫn có thứ tự thời gian, nhưng không cho biết chính xác “đây là user thứ bao nhiêu”.
UUIDv7 giải quyết gì từ UUIDv4?
3.4. Giảm random insert vào B-tree
UUIDv4 random toàn bộ, nên insert rơi lung tung trong index.
UUIDv7 có timestamp ở đầu, nên các ID mới thường nằm gần cuối B-tree.
Điều này giúp giảm:
- Page split.
- Index fragmentation.
- Random I/O.
- Cache miss.
- Write amplification.
Nói chính xác hơn: UUIDv7 không loại bỏ hoàn toàn page split. Database nào dùng B-tree cũng vẫn có page split khi page đầy hoặc khi có concurrency/clock skew. Nhưng UUIDv7 làm pattern insert “có trật tự” hơn nhiều, nên giảm đáng kể vấn đề mà UUIDv4 gây ra.
3.5. Vẫn giữ khả năng sinh phân tán
UUIDv7 vẫn có random/entropy bits, nên nhiều node có thể sinh ID cùng thời điểm mà xác suất collision vẫn cực thấp nếu implementation đúng.
3.6. Có tính sort theo thời gian
Điều này tiện cho nhiều use case:
- List bản ghi mới nhất.
- Event log.
- Audit log.
- Message ID.
- Order/event timeline.
- Pagination theo thời gian.
Bạn có thể sort theo ID để gần tương đương sort theo creation time, dù trong hệ thống nghiêm túc vẫn nên có cột created_at riêng.
4. So sánh sâu hơn: database nhìn thấy gì?
Auto-increment
Insert mới -> cuối index -> ít di chuyển dữ liệu
Database thích pattern này vì nó tuyến tính, dễ cache, dễ predict.
UUIDv4
Insert mới -> vị trí random -> có thể phải split page
Database phải làm nhiều việc hơn cho cùng một số lượng insert.
UUIDv7
Insert mới -> gần cuối index theo thời gian -> vẫn random bên trong cùng timestamp window
Nó là điểm cân bằng: không nhỏ bằng integer, nhưng thân thiện với index hơn UUIDv4.
5. Lưu ý thực tế với PostgreSQL
5.1. Dùng kiểu uuid, đừng dùng text/varchar
PostgreSQL có native type uuid. Hãy dùng:
CREATE TABLE users (
  id uuid PRIMARY KEY,
  email text NOT NULL UNIQUE
);
Không nên lưu UUID bằng varchar(36) nếu không có lý do đặc biệt.
5.2. PostgreSQL version và function UUIDv7
PostgreSQL historically có gen_random_uuid() cho UUIDv4 qua pgcrypto.
Với UUIDv7, tuỳ version bạn đang dùng:
- Có thể dùng extension/library hỗ trợ UUIDv7.
- Có thể generate ở application layer.
- Với các PostgreSQL version mới hơn, cần kiểm tra function built-in hiện có trong môi trường của bạn.
Điểm quan trọng: implementation phải đúng chuẩn và đủ entropy.
5.3. UUIDv7 không thay thế created_at
Dù UUIDv7 có timestamp, vẫn nên có:
created_at timestamptz NOT NULL DEFAULT now()
Lý do:
- Query business rõ ràng hơn.
- Dễ index/filter/report.
- Không phụ thuộc logic parse UUID.
- Dễ xử lý timezone/time precision.
6. Lưu ý thực tế với MySQL/InnoDB
6.1. Clustered primary key làm vấn đề rõ hơn
InnoDB lưu table data theo clustered primary key. Primary key ảnh hưởng trực tiếp đến layout dữ liệu.
Nếu dùng UUIDv4 làm primary key, insert random có thể làm clustered index phân mảnh mạnh hơn.
Vì vậy với MySQL/InnoDB, lựa chọn primary key càng cần cân nhắc.
6.2. Nếu dùng UUID, cân nhắc BINARY(16)
Thay vì CHAR(36), có thể lưu UUID dưới dạng binary:
id BINARY(16) PRIMARY KEY
Điều này tiết kiệm storage/index hơn.
6.3. MySQL có UUID_TO_BIN(..., swap_flag) cho UUIDv1-style ordering
MySQL có hàm hỗ trợ reorder byte để UUID có tính locality hơn trong một số trường hợp. Nhưng với UUIDv7, bạn nên kiểm tra kỹ library/encoding để đảm bảo byte order sort đúng như mong muốn.
7. Có nên dùng UUID làm primary key luôn không?
Không có đáp án duy nhất.
Option A: Dùng BIGINT làm internal PK, UUID/UUIDv7 làm public ID
Ví dụ:
CREATE TABLE users (
  id bigint generated always as identity primary key,
  public_id uuid not null unique,
  email text not null unique
);
Ưu điểm:
- Database join/index nội bộ vẫn nhanh với BIGINT.
- API public dùng UUID khó đoán.
- Dễ migration từ hệ cũ.
Nhược điểm:
- Có thêm một unique index.
- App phải quản lý hai loại ID.
- Dễ nhầm
idvàpublic_idnếu codebase không clean.
Option B: Dùng UUIDv7 làm primary key
Ưu điểm:
- Một ID duy nhất cho cả internal và external.
- Sinh phân tán tốt.
- Index-friendly hơn UUIDv4.
- Hợp với microservices/event-driven.
Nhược điểm:
- Key vẫn lớn hơn BIGINT.
- Cần library/support tốt.
- Có thể lộ timestamp tương đối.
Option C: Dùng auto-increment thuần
Ưu điểm:
- Đơn giản nhất.
- Hiệu quả nhất về storage/index.
- Rất phù hợp CRUD app đơn node.
Nhược điểm:
- Không nên expose thẳng ra public API nếu không kiểm soát tốt.
- Khó sinh ID phi tập trung.
- Lộ volume/thứ tự.
8. Security: UUID không phải authorization
Đây là điểm đáng nhấn mạnh.
Dùng UUID/UUIDv7 giúp ID khó đoán hơn, nhưng không sửa được bug kiểu này:
User A request /orders/<uuid-của-user-B>
Server trả order vì order tồn tại
Đúng phải là:
Server kiểm tra order thuộc User A hoặc User A có quyền xem order đó
ID khó đoán là một lớp giảm rủi ro enumeration, không phải permission model.
9. Recommendation thực chiến
Nếu làm app nhỏ/vừa, single database
Dùng BIGINT auto-increment/identity là lựa chọn tốt.
Nếu cần public URL khó đoán, thêm public_id dạng UUIDv7/UUIDv4.
Nếu làm API public, SaaS, multi-tenant
Ưu tiên không expose integer ID trực tiếp.
Có thể dùng:
BIGINT idnội bộ +UUIDv7 public_idpublic.- Hoặc UUIDv7 làm primary key nếu muốn một ID xuyên suốt hệ thống.
Nếu làm distributed system/microservices/event-driven
UUIDv7 rất đáng cân nhắc vì:
- Sinh ID độc lập.
- Có tính ordered theo thời gian.
- Ít phá B-tree hơn UUIDv4.
- Phù hợp event/order/message IDs.
Nếu đang dùng UUIDv4 và write performance/index size là vấn đề
Nên benchmark UUIDv7 hoặc một time-ordered ID khác như ULID/KSUID/Snowflake.
Đừng đổi production chỉ vì trend. Hãy đo:
- Insert throughput.
- Index size.
- Cache hit ratio.
- WAL/redo volume.
- Query latency.
- Bloat/fragmentation.
10. Kết luận
Cuộc tranh luận “auto-increment hay UUID” hơi thiếu một mảnh ghép.
Auto-increment rất nhanh vì nó nhỏ và tuần tự. Nhưng nó dễ đoán, lộ thông tin và không tự nhiên trong hệ phân tán.
UUIDv4 giải quyết chuyện sinh ID phi tập trung và khó đoán, nhưng vì random nên database phải chịu chi phí lớn hơn: page split, fragmentation, index bloat, cache miss.
UUIDv7 nằm giữa hai thế giới:
UUIDv7 = ordered như integer + distributed như UUID + khó đoán hơn auto-increment
Nó không phải silver bullet, nhưng với nhiều backend hiện đại, đặc biệt là API public và distributed systems, UUIDv7 là default tốt hơn UUIDv4 rất nhiều.
Nếu phải chọn nhanh:
- Internal CRUD app:
BIGINTauto-increment. - Public ID: UUIDv7.
- Distributed/event-driven: UUIDv7.
- UUIDv4: chỉ dùng khi bạn thật sự không quan tâm nhiều đến ordering/index locality, hoặc workload không bị ảnh hưởng đáng kể.
Database không chỉ quan tâm ID có unique hay không. Nó còn quan tâm ID đó đi vào B-tree như thế nào.